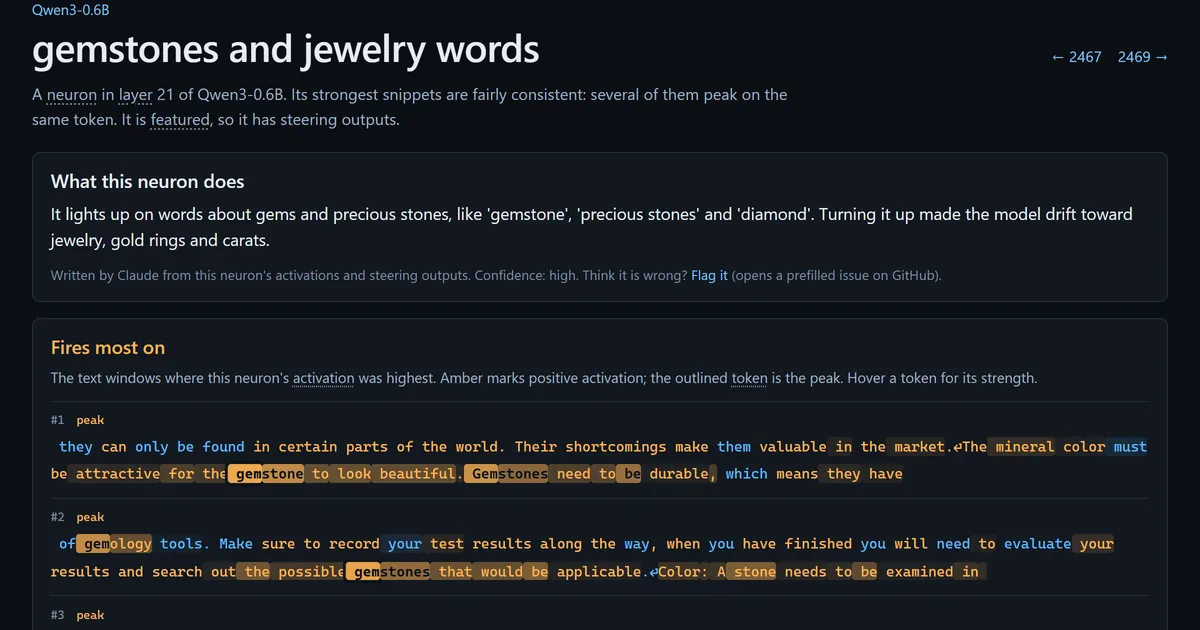
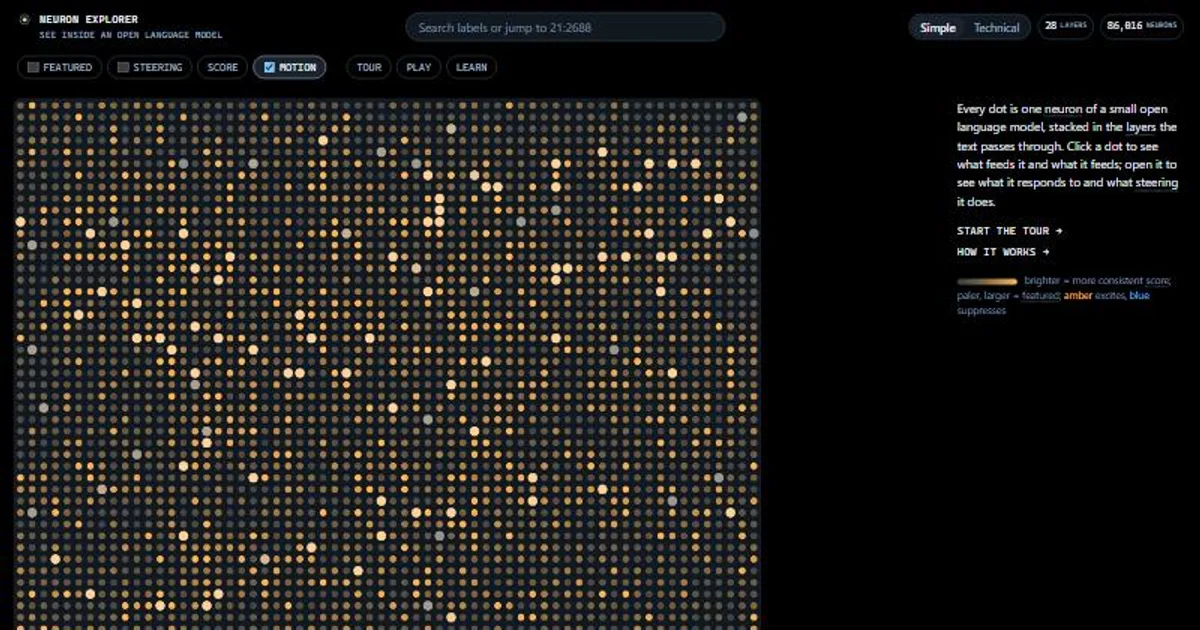
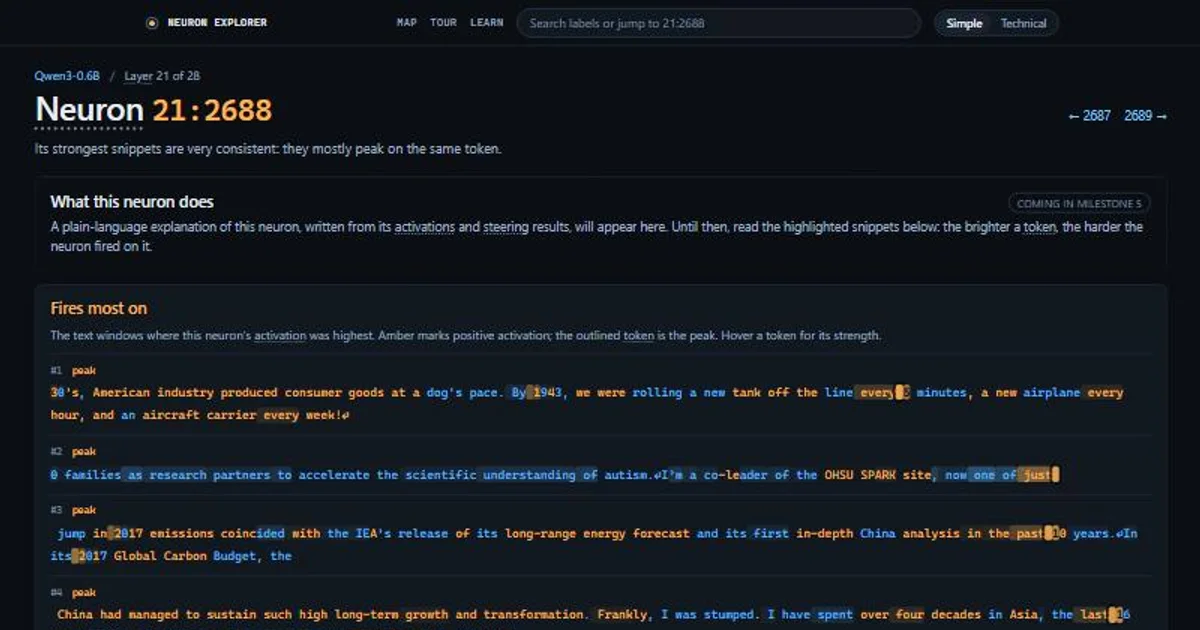
Wat het is. Over taalmodellen praten we meestal alsof het een zwarte doos is: je typt iets in, er komt antwoord uit. Neuron Explorer maakt die doos open. Qwen3-0.6B, een klein open model, bestaat uit 86.016 neuronen en elk daarvan is hier een stip op een kaart. Klik op een stip en je komt op de pagina van dat ene neuron. Daar staan de zinnen waarop het het hardst reageerde, gevonden in twee miljoen woorden tekst van het web, met per woord gemarkeerd hoe hard. Je ziet ook op welke zinnen het juist afslaat, naar welke woorden het het model toe stuurt, en met welke andere neuronen het in verbinding staat. Bij zo’n drieduizend neuronen staat er bovendien in gewone taal bij wat Claude ervan maakt, en zit er een schuif onder: beweeg die en je ziet veranderen wat het model schrijft. Er staat geen plaatje op de site dat bedacht is. Alles komt uit het model zelf.
Waarom ik dit bouw
Een taalmodel is uiteindelijk een bestand vol getallen. Bij Qwen3-0.6B zijn dat er zo’n 600 miljoen, en niemand kan die lezen, ook de makers niet. Wat wel kan: het model aanzetten en meekijken. Tekst erin, bijhouden wat elk onderdeel doet, en dan aan één onderdeel draaien om te zien wat er verandert. Dat wilde ik een keer zelf doen in plaats van erover lezen. Het onderzoek naar wat er in modellen gebeurt (interpretability) hoort bij het spannendste dat er op dit moment in AI gebeurt, maar bijna al dat werk speelt zich af op modellen waar je als buitenstaander niet bij kunt. Met een klein open model en een pc thuis kun je verrassend ver komen: activaties opslaan, de neuronen in kaart brengen, eraan draaien, en zelf nagaan hoeveel er klopt van het idee dat “het model een neuron voor X heeft”.
Mijn werk speelt ook mee. Als AML-analist geloof ik een systeem niet op zijn woord; ik wil de onderliggende gegevens zien. Bij een taalmodel zijn de antwoorden wat het over zichzelf vertelt. De activaties zijn de administratie.
Het idee komt van de neuron-explorer van lyramakesmusic. De code is vanaf nul geschreven. De modellen van Anthropic zijn gesloten, dus het onderwerp moest een open model zijn; Claude kreeg een andere rol: het schreef bij elk uitgelicht neuron de uitleg in gewone taal en koos de rondes voor het spel.
Zo werkt het
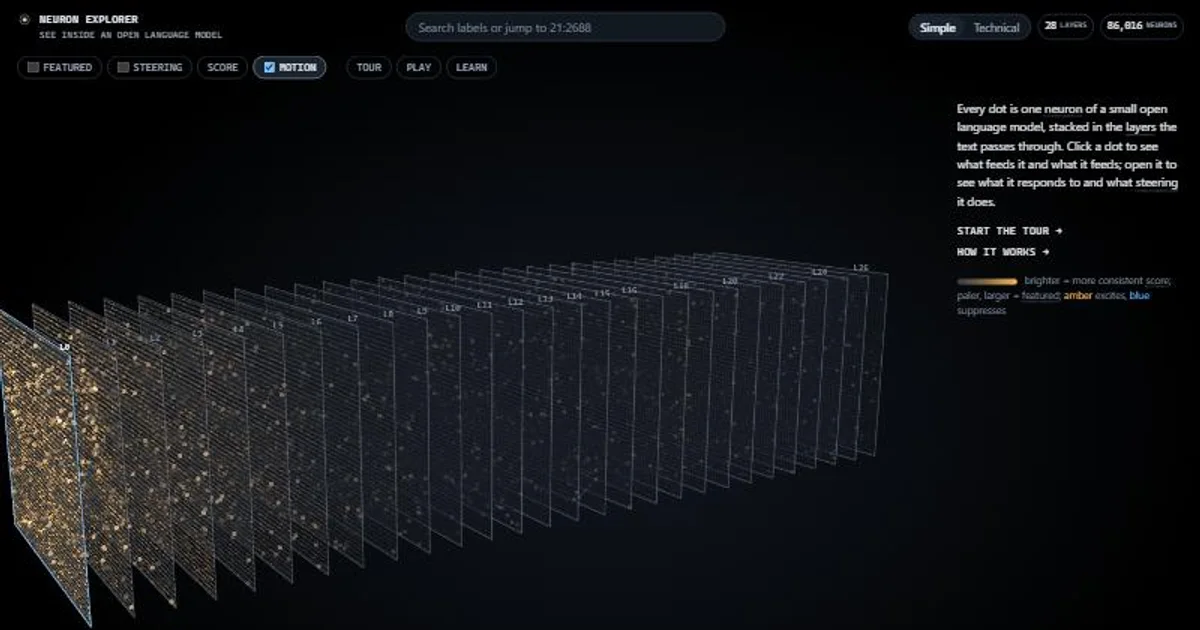
Het model staat op de kaart als 28 doorschijnende vellen boven elkaar, één per laag, elk een raster van 3.072 stippen. Neuronen die ongeveer hetzelfde doen liggen bij elkaar, dus je ziet buurten ontstaan. Je kunt om de stapel heen draaien, inzoomen, laag voor laag doorlopen of direct een neuron opzoeken op nummer. Klik je een stip aan, dan schieten er lijnen door de stapel: oranje naar de neuronen die het aanzet, blauw naar de neuronen die het afremt. Open het neuron en je staat op zijn eigen pagina. Wil je geen vaktaal en geen getallen, dan zet je de schakelaar op Simpel; op Technisch krijg je alles. Elke term heeft bovendien een korte uitleg zodra je er met de muis overheen gaat.
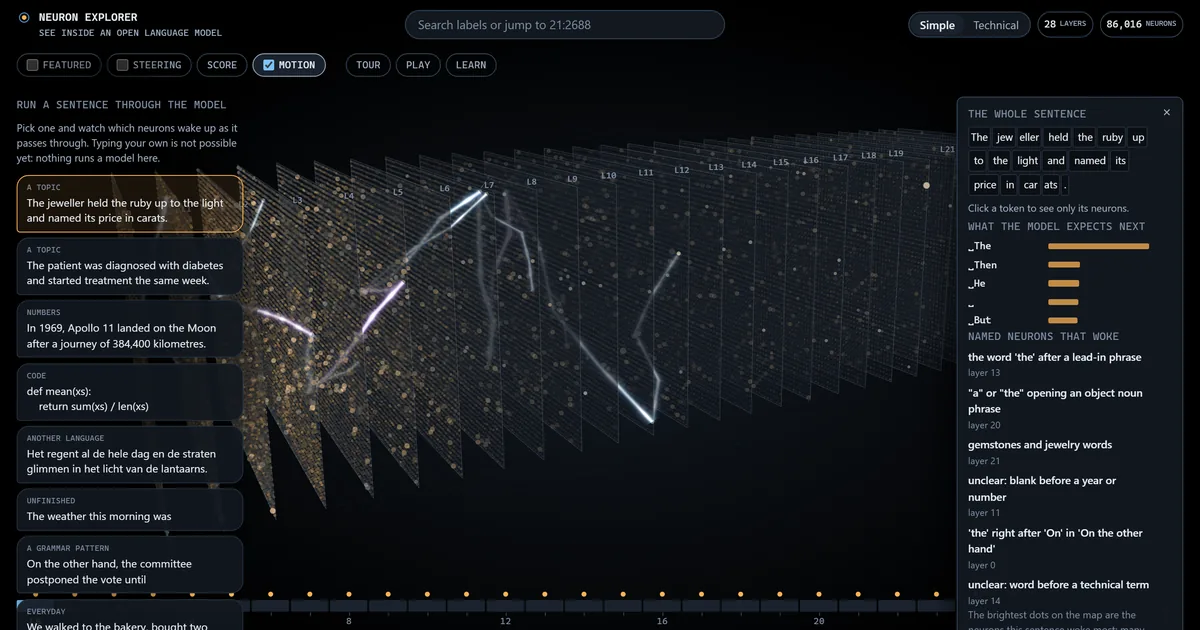
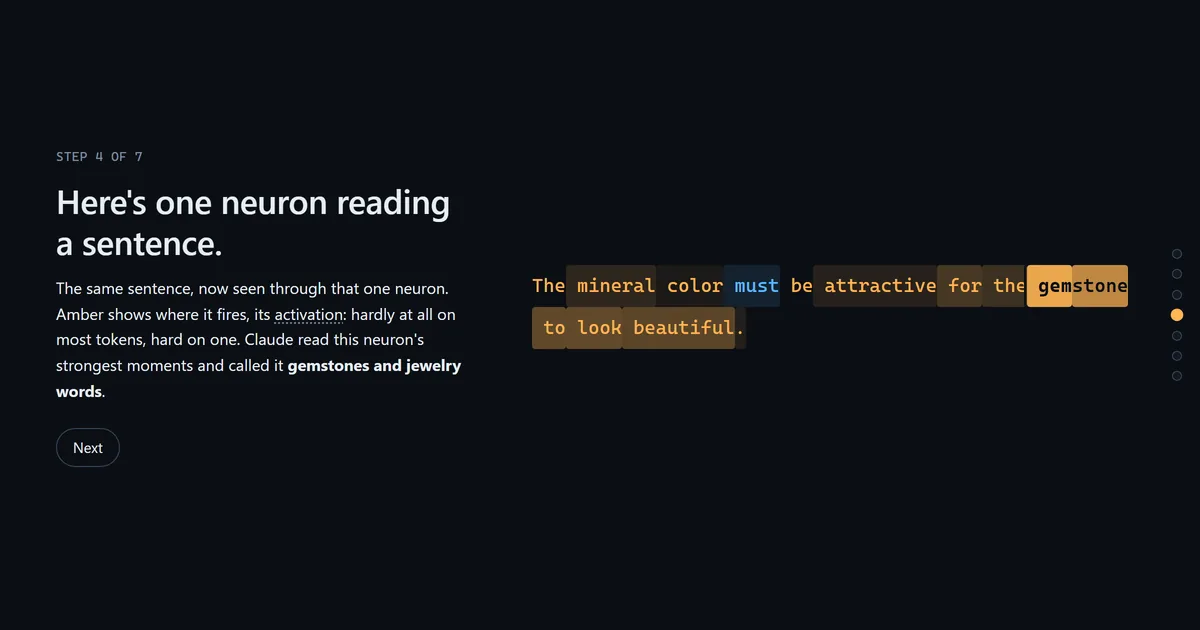
Stuur er een zin doorheen. Op de kaart staat links een kader met acht kant-en-klare zinnen: een over edelstenen, een uit de kliniek, een maanlanding met jaartal en afstand, twee regels Python, een Nederlandse zin, een zin die halverwege ophoudt, een grammaticapatroon en een alledaagse. Kies er een en een bliksemflits klimt laag voor laag door de stapel en slaat in bij de neuronen die het hardst reageerden. Rechts staat een paneel met de zin in tokens, wat het model hierna verwacht en welke benoemde neuronen er wakker werden. Klik je een token aan, dan blijft alleen dat woord over. De juweliers-zin wekt het edelsteenneuron uit de rondleiding op zo’n zestig procent van de hardste uitslag die het in de steekproef ooit had, en geen neuron in die laag reageert harder. Zelf een zin typen kan niet, en dat staat er ook bij: er draait nergens een model.
Is de kaart te veel ineens, dan neemt de rondleiding je in zeven scènes mee van tokens naar sturen, legt de Learn-pagina de vier begrippen uit die je nodig hebt en staat daar ook de begrippenlijst, en kun je in het spel testen of je een neuron herkent aan zijn bijgestuurde tekst. Op de startpagina staat verder elke dag een ander neuron van de dag.
Wat ik heb gezien
- Een neuron stelt minder voor dan het woord suggereert. Het is één getal per token. Het leest de tussenstand die het model van laag naar laag meeneemt en telt daar zijn eigen richting bij op. De pagina van een neuron is niets anders dan dat ene getal, twee miljoen keer gemeten en op volgorde gezet.
- Een paar neuronen zijn glashelder, de meeste niet. Laag 21, neuron 2688 slaat aan op het woord vóór een getal. Laag 5, neuron 74 reageert op verwijzingen naar wetsteksten. Dat zijn de makkelijke gevallen, en de score op de site trekt daar ook naartoe, want die beloont neuronen die telkens op hetzelfde token pieken. Klik een willekeurige stip aan en de topzinnen hebben vaak niets zichtbaars met elkaar te maken. “Eén neuron, één begrip” geldt maar voor een klein deel van het model. De uitleg van Claude zegt hetzelfde in cijfers: van de 2.996 uitgelichte neuronen was het er bij 325 zeker van. De rondleiding laat daarom expres ook een rommelig neuron zien.
- Neuronen slaan twee kanten op uit. Ze kunnen net zo sterk negatief als positief gaan, en de negatieve kant betekent vaak iets anders dan gewoon “minder van hetzelfde”. Daarom staan beide lijsten op elke pagina.
- Elke laag heeft zijn eigen werk. Vooraan reageren neuronen op stukjes woord en op opmaak. In het midden levert de logit lens (lees je rechtstreeks uit de gewichten af welke woorden een neuron naar voren duwt) vooral ruis op, omdat de tekst daar nog midden in de verbouwing zit. Achteraan wordt het leesbaar en stemt een neuron zichtbaar op concrete woorden. De tussenstand die het model meeneemt wordt onderweg ook zo’n tien keer groter, dus een duw van dezelfde kracht doet in laag 5 iets heel anders dan in laag 25.
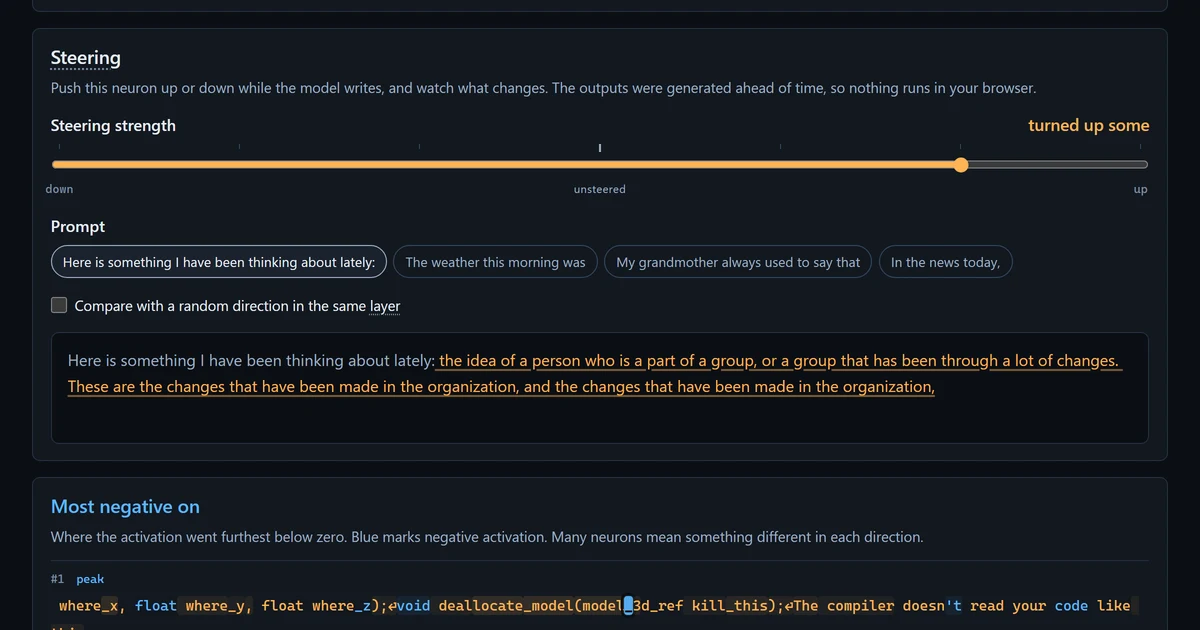
- Sturen werkt alleen binnen een smalle marge. Een klein zetje en het onderwerp verschuift terwijl de tekst gewoon leesbaar blijft. Een hard zetje en het model blijft hangen in herhalingen. En een willekeurige richting van dezelfde kracht doet óók iets. Daarom zit er bij elke schuif een knop om te vergelijken met zo’n willekeurige richting: zonder die controle weet je niet of je het neuron ziet werken of gewoon het model ziet wankelen.
- De bedrading staat deels in de gewichten zelf. Welke neuronen latere neuronen aanzetten of afremmen kun je uitrekenen zonder ook maar één zin door het model te halen (attention laat je daarbij buiten beschouwing). Het is een onvolledig schema, maar het klopt genoeg om structuur te zien: neuronen met een vergelijkbare uitvoerrichting liggen op de kaart bij elkaar, en de lijnen door de stapel volgen echte verbanden.
- Wat een neuron “doet” hangt af van wat je het hebt laten lezen. In mijn eerste corpus stond de chatmarkering van het model als scheidingsteken tussen documenten, en een handvol neuronen leek nergens anders over te gaan. Andere data, ander verhaal. Elke uitleg op de site gaat dus over dit model op twee miljoen tokens educatieve webtekst, en dat staat er ook bij.
- Tokens zijn geen woorden, en het model denkt niet in het Engels. De woordenschat is meertalig. Een neuron dat “eighty” en “seventy” naar voren schuift, doet hetzelfde met de Chinese telwoorden. Getallen uit allerlei talen zitten op dezelfde plek.
- De eerste lagen trekken zich van je zin niets aan. In laag 0 tot en met 2 zijn de luidste neuronen bij elke zin dezelfde: detectoren voor positie en veelvoorkomende tokens, die altijd tot het maximum uitslaan. Daarom noemt het paneel de benoemde neuronen apart van de luidste. Dat de vroege lagen op oppervlakkige kenmerken reageren is zelf al een les.
- Zelfs dit kleine model is al te groot om te lezen. Het draait op een gewone processor, maar neuron voor neuron doorlopen is onbegonnen werk: de uitgelichte set is 2.996 van de 86.016, nog geen vier procent. Een model begrijpen begint met goed gereedschap, en daarom bestaat deze site.
Drie neuronen om mee te beginnen
Laag 21, neuron 2468 is het voorbeeld uit de rondleiding: het slaat aan op edelstenen en sieraden, en met een klein zetje gaan de overpeinzingen van het model ineens over karaat en gouden ringen. Laag 5, neuron 74 reageert op juridische verwijzingen: “42 U.S.C. § 1395”, amendementen, wetsartikelen. Geef het een klein zetje en het nieuwsbericht van het model gaat ineens over overheid en beleid. Zet de schuif helemaal open en de tekst valt uit elkaar in herhalingen. Dat is op zichzelf al leerzaam: sturen is grof gereedschap, en de schuif laat precies zien waar het misgaat. Laag 21, neuron 2688 slaat aan op het woord vlak vóór een getal. Draai je het omlaag, dan schrijft het model rijen cijfers. Draai je het omhoog, dan ontwijkt het getallen en wordt het breedsprakig.
Waar het nu staat
Af, voor het eerste model. Heel Qwen3-0.6B is doorgerekend. Twee miljoen tokens educatieve webtekst gingen erdoorheen op de processor van mijn game-pc, want voor de AMD-kaart bestaat op Windows geen PyTorch. Anderhalf uur voor de doorloop zelf, nog eens tweeënhalf uur om de 86.016 bestanden weg te schrijven. De uitgelichte neuronen zijn ‘s nachts bijgestuurd: vier prompts, zeven sterktes, 48 tokens per keer, plus willekeurige controlerichtingen om echte effecten van toeval te kunnen scheiden. Daarna schreef Claude in nog geen uur bij alle 2.996 een uitleg en beoordeelde het elk neuron voor het spel, wat 341 rondes opleverde. De rondleiding, de begrippenlijst en het spel kwamen daarna, samen met een neuron van de dag op de startpagina en een meldlink onder elke uitleg. Als laatste kwamen Trace en een korte openingsanimatie waarin de lagen groeien. De data achter de site is ruim 650 MB gecomprimeerd en komt als kant-en-klare bestanden van een kleine VPS. Er draait geen model op de server.
Wat overblijft is een tweede model. Daarvoor draai ik de pipeline opnieuw; aan de site hoeft niets te veranderen. Zelf een zin intypen komt er pas als de kant-en-klare zinnen veel gebruikt worden: dan moet het model in de browser van de bezoeker draaien of op een kleine server. Elk open model kan er zo doorheen.